模型是商品,Harness 才是护城河:让 Agent 敢对结论负责的工程纪律
模型是商品,Harness 才是护城河:让 Agent 敢对结论负责的工程纪律
Agent 圈流传一句话:「模型是商品,harness 才是护城河」。所有「高风险 + 复杂分支 + 结论必须可解释」的决策场景,都会撞上同一堵墙——模型是概率性的,而结论必须是确定性的。
这篇文章不聊怎么把模型调得更聪明,而是回答一个更普遍的问题:在高风险决策场景里,如何把 Agent 概率性的输出,约束成可交付的确定性结论?
我们给出的答案是确定性 Harness。它只做四件事:
- 阶段化编排——把策略文档拆成代码流水线;
- 全链路留痕——FlowTracer 记录每一步的输入、输出与分支;
- 提前终止——IsFinal 短路,能下结论就停;
- 统一网关与缓存——稳住外部依赖,幂等内部响应。
在这套骨架里,LLM 不是主角,只是一个可以随时插拔的判断单元。
我们用工单审核业务验证了这套框架:九个阶段、几十个条件分支、六步顺序校验,背后是策略文档、十几个原子接口和用户提交的多类材料——只要判错一单就是客诉,典型的「结论必须负责」场景。
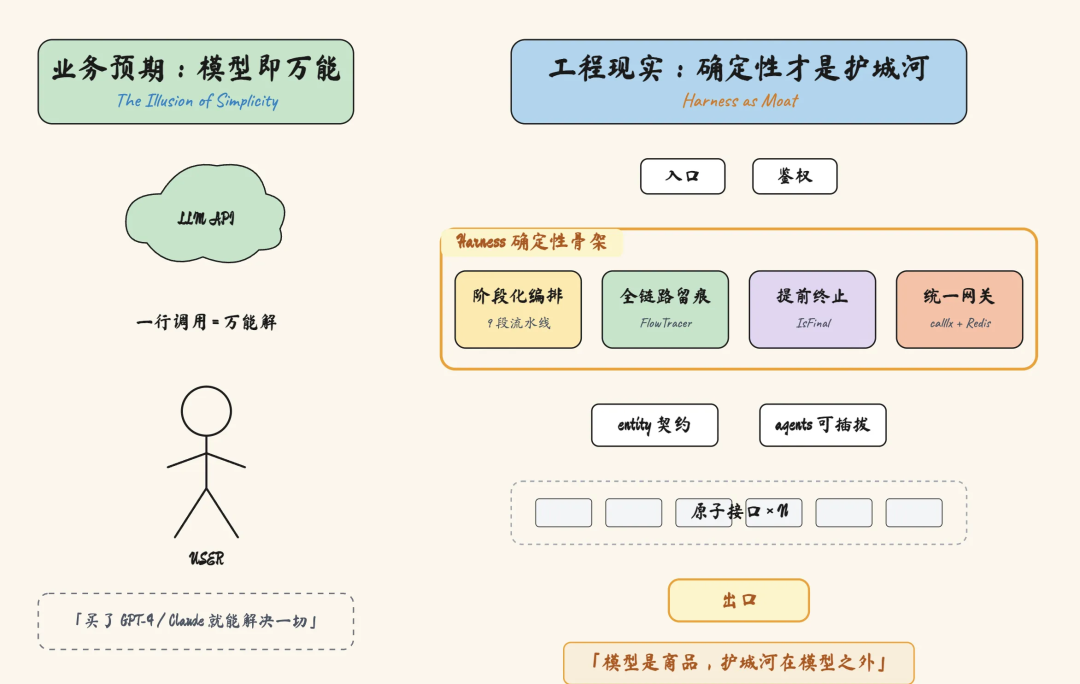
一、「接个 LLM 就够」是错觉
工单审核结果直接决定用户、商家的权益与合规认定。这个场景里,Agent 真正的门槛从来不是「模型能不能答对」,而是「它答完之后,谁来为这个答案负责」。模型能生成答案,却无法为答案背书;一个敢上线的 Agent,必须让每个结论都能被验证、被追溯、被追责。
过去一个工单从进来到出结论,靠的是一条「人肉流水线」:审单员手动调接口、肉眼比对材料。而「接个 LLM 就能自动化」的想法,往往死在这些工程细节上——三个问题随之而来:
- 黑盒不可解释:审单员、用户、监管问「为什么驳回」,纯 LLM 答不上来;
- 循环失控:工具调用链长、字段错配,模型一「死循环」就卡住整条流水线;
- 证据链断裂:接口、模型、人工补充混在一起,事后复盘找不到「这一单凭什么这么判」。
二、根子是确定性与概率性的矛盾
这三个坎,换更聪明的模型、写更精致的 prompt 都绕不过去,因为它们指向同一个根源:LLM 本质上是概率性的,而审核要的是确定性。
模型给的是「最可能的回答」,不是「必然正确的回答」。同一句话换个问法,答案可能不同;同一张工单重跑一遍,结论可能漂移。放在写文案、做摘要里,这叫「创造力」;放在审单里,就意味着同一条规则下,A 用户被判「驳回」、B 用户被判「通过」——这不可接受。
Harness 做的所有事,本质上都是在为这道鸿沟搭桥:用编排固定路径,用留痕固定证据,用终止固定边界,用网关固定依赖。桥搭稳了,模型这个「概率性部件」才能被安全地装进「确定性机器」里。
三、Harness 的四个关键设计
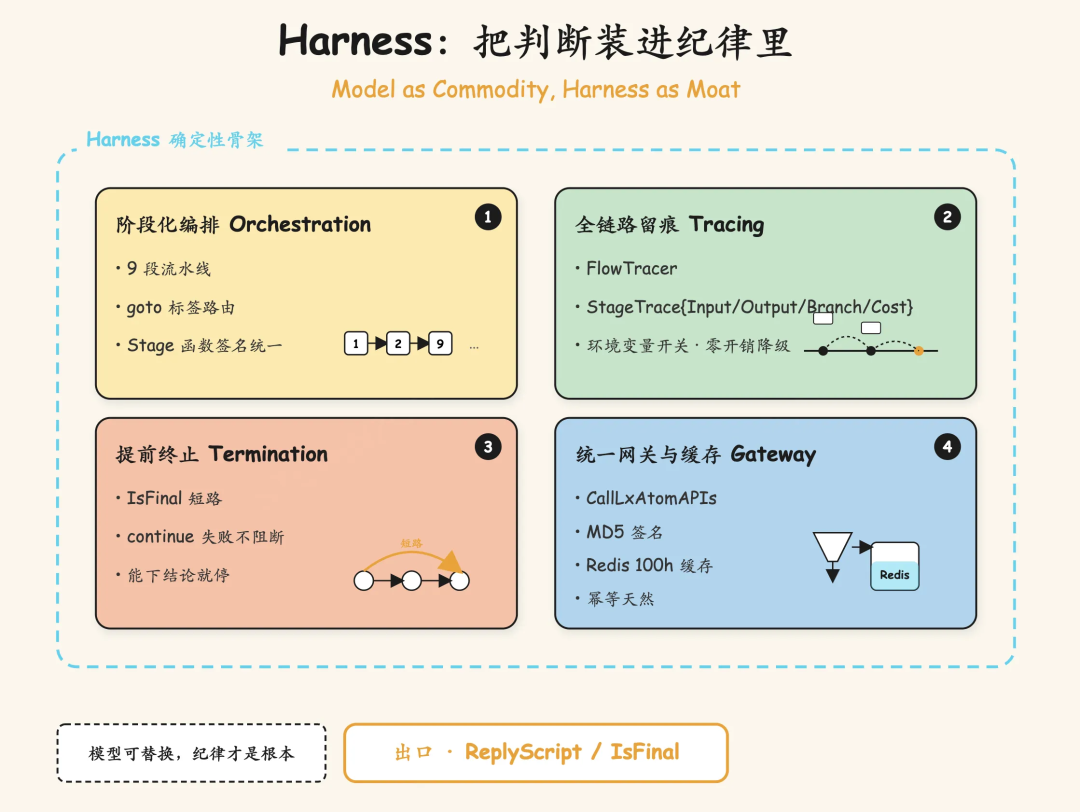
这四件事不是并列的技巧,而是一条环环相扣的闭环:编排回答「该走哪条路」,留痕回答「走完怎么证明」,终止回答「走到哪一步就够了」,网关回答「外部依赖怎么稳住」。少了留痕,出错无从查起;少了终止,就是「明知结果还要跑完全程」;少了网关,再完善的编排也会被不稳定上游反复打断。缺一个,闭环就断了。
3.1 阶段化编排:goto 标签路由
挑战:策略文档几十个分支,深层 if/else 会晦涩冗长。
方案:拆成签名统一的阶段函数,每个函数只做一件事、只写自己负责的字段;主流程用 goto 标签把「条件命中 → 规则匹配 → 信息提取 → 状态判定 → 材料核验 → 打标结单」串成一条线性可读的主干。新增一个判断点,就是新增一个函数加一段编排,不动既有分支。
1 | func (a *Agent) Main(ctx context.Context) (*Result, error) { |
goto 在大众认知里是「坏味道」,但在分支密集的编排里,它反而是让主干保持线性的最直白手段。策略文档改动只需重写对应阶段函数,主流程骨架稳定不动。
3.2 全链路留痕:FlowTracer
挑战:阶段一多,每一步「为什么这么判」就没人记得住了。
方案:追踪器是一个阶段记录数组——每个阶段 BeginStage 开档,SetInput / SetBranch / SetOutput / SetError 记数据,EndStage 收尾算耗时,整个数组随结果一起返回,逐阶段可回放。
1 | var debugEnabled = os.Getenv("AGENT_DEBUG") != "0" |
关键设计是 nil 安全降级:debug 关闭时 tracer 为 nil,所有方法第一行都是 if t == nil { return }——线上零开销;需要排查时改一个环境变量即可全量开启。可解释是刚需,但「需要时能查」和「平时不拖累」必须同时成立,否则留痕自己就会变成新的性能包袱。
3.3 提前终止:IsFinal 短路
挑战:六步顺序校验里,前面已经能下结论的工单,没必要把后面全跑一遍。
方案:整个校验流程是声明式 handler 列表,主循环按顺序执行——单个 handler 失败只记日志继续走(continue);一旦某个 handler 判定「已有最终结论」,置 IsFinal=true,主循环立即 break。
1 | for i, handler := range a.buildWorkFlow() { |
continue 保证单步异常不炸全链路,IsFinal 保证能下结论就停——不让「已知结果还跑完全程」。
3.4 统一网关与缓存
十几个原子接口签名各搞各的、同一工单重复查询反复打接口,怎么办?所有原子接口收口到同一条 CallLxAtomAPIs(MD5 签名封装),结果按 TaskID 落 Redis 100 小时缓存。上游签名统一后业务层只关心路径和 body,重复请求直接命中缓存,天然幂等。
3.5 四件事的内在一致性
拆开看各解决一个问题,合起来遵循同一条原则:把「不可控」关进「可控」的笼子。编排关住分支,留痕关住黑盒,终止关住循环,网关关住依赖——四个「可控」指向同一个词:确定性。所以这套骨架能沉淀成可复用的模式,换个场景,解法不变。
四、实战效果
- 量化提效:工单平均处理耗时从 2–3 分钟压缩到 20–40 秒;
- 能力下沉:审核员从「手动调接口 + 肉眼比对」变成「看结论 + 调 DebugTrace 回放」;开发从「每个接口写样板代码」变成「只写阶段业务判断」;
- 模式升级:这套思路可以从审单搬到任何「强监管 + 复杂分支」的决策场景。
两个典型案例:多分支审单主线里,几十个分支的策略文档被翻译成「阶段函数 + 标签路由」的确定性代码,面对用户质疑时调出 DebugTrace 就能逐条回放;提前结单场景里,基础信息校验一步判定「信息不存在」即置 IsFinal=true 立即短路,审核员 3 秒内拿到驳回结论,而不是等 5 个步骤跑完。
五、反直觉的取舍
这套框架里有几个决策看起来「反常识」,恰恰最值得说:
- 单一阶段失败不阻断。工程直觉是「出错就该停」,但审单场景里一个接口超时不该让整单卡死——「带着伤口的结论」好过「没有结论」。
- 留痕默认关着。可解释是刚需,但让它默认零开销,留痕才不会变成新的性能包袱。
- 用 goto 而非「更优雅」的结构。在分支密集的编排里,goto 是让主干保持线性的最直白手段。
这些取舍提醒我们:Agent 工程不是把软件工程的老规矩照搬过来,而是回到「这个场景到底要什么」重新做判断。
六、适用边界
这套方案不适合:纯生成式任务(文案、翻译、摘要,prompt 工程就够);必须 100% 黑盒的探索性任务(可解释诉求与之冲突);单次调用、无循环无工具的轻量任务(没有发挥空间)。
核心判断:「高风险 + 复杂分支 + 必须可解释」选 Harness 优先;「低风险 + 灵活开放 + 追求吞吐」直接用模型即可。
更进一步:Harness 解决的是「结论要负责」,不是「结论要更快」。如果场景根本不在乎结论可不可解释、可不可追溯,那 Harness 的每一层都是纯成本。该不该上 Harness,本质是问一句:这个 Agent 的结论,需不需要对某个人、某条规则、某次检查负责? 需要,就值得为确定性付出工程成本;不需要,就让它自由地快。
LLM 的介入程度也可以分级:L1 模型直接出结论,L2 模型给建议、人工拍板,L3 模型只能给 SOP、禁止自动执行。
结语
阶段化编排,把复杂分支翻译成可读流程;全链路留痕,让每次判断有迹可循;提前终止,在能下结论时立刻收口;统一网关与缓存,把外部依赖关进笼子。
四件事没有一件是为了让模型更聪明。它们补的是模型天生缺的那块——约束与规范化的工程。让 Agent 敢对结论负责的,从来不是模型的智力,而是模型之外那层纪律。